ALPHA
Aziende medio-grandi · Workload agentici e vibe coding

Ti presento
Ventic.

Una nuova infrastruttura dichiarativa e intent-driven per fare il deploy dei tuoi LLM e regolarne l'accesso. Crea la tua infrastruttura LLM privata con l'esperienza di un provider, a colpo d'occhio!

Accedi gratis alla fase alpha. Scrivici a Mostra email o mandami un messaggio diretto per richiedere l'accesso anticipato.

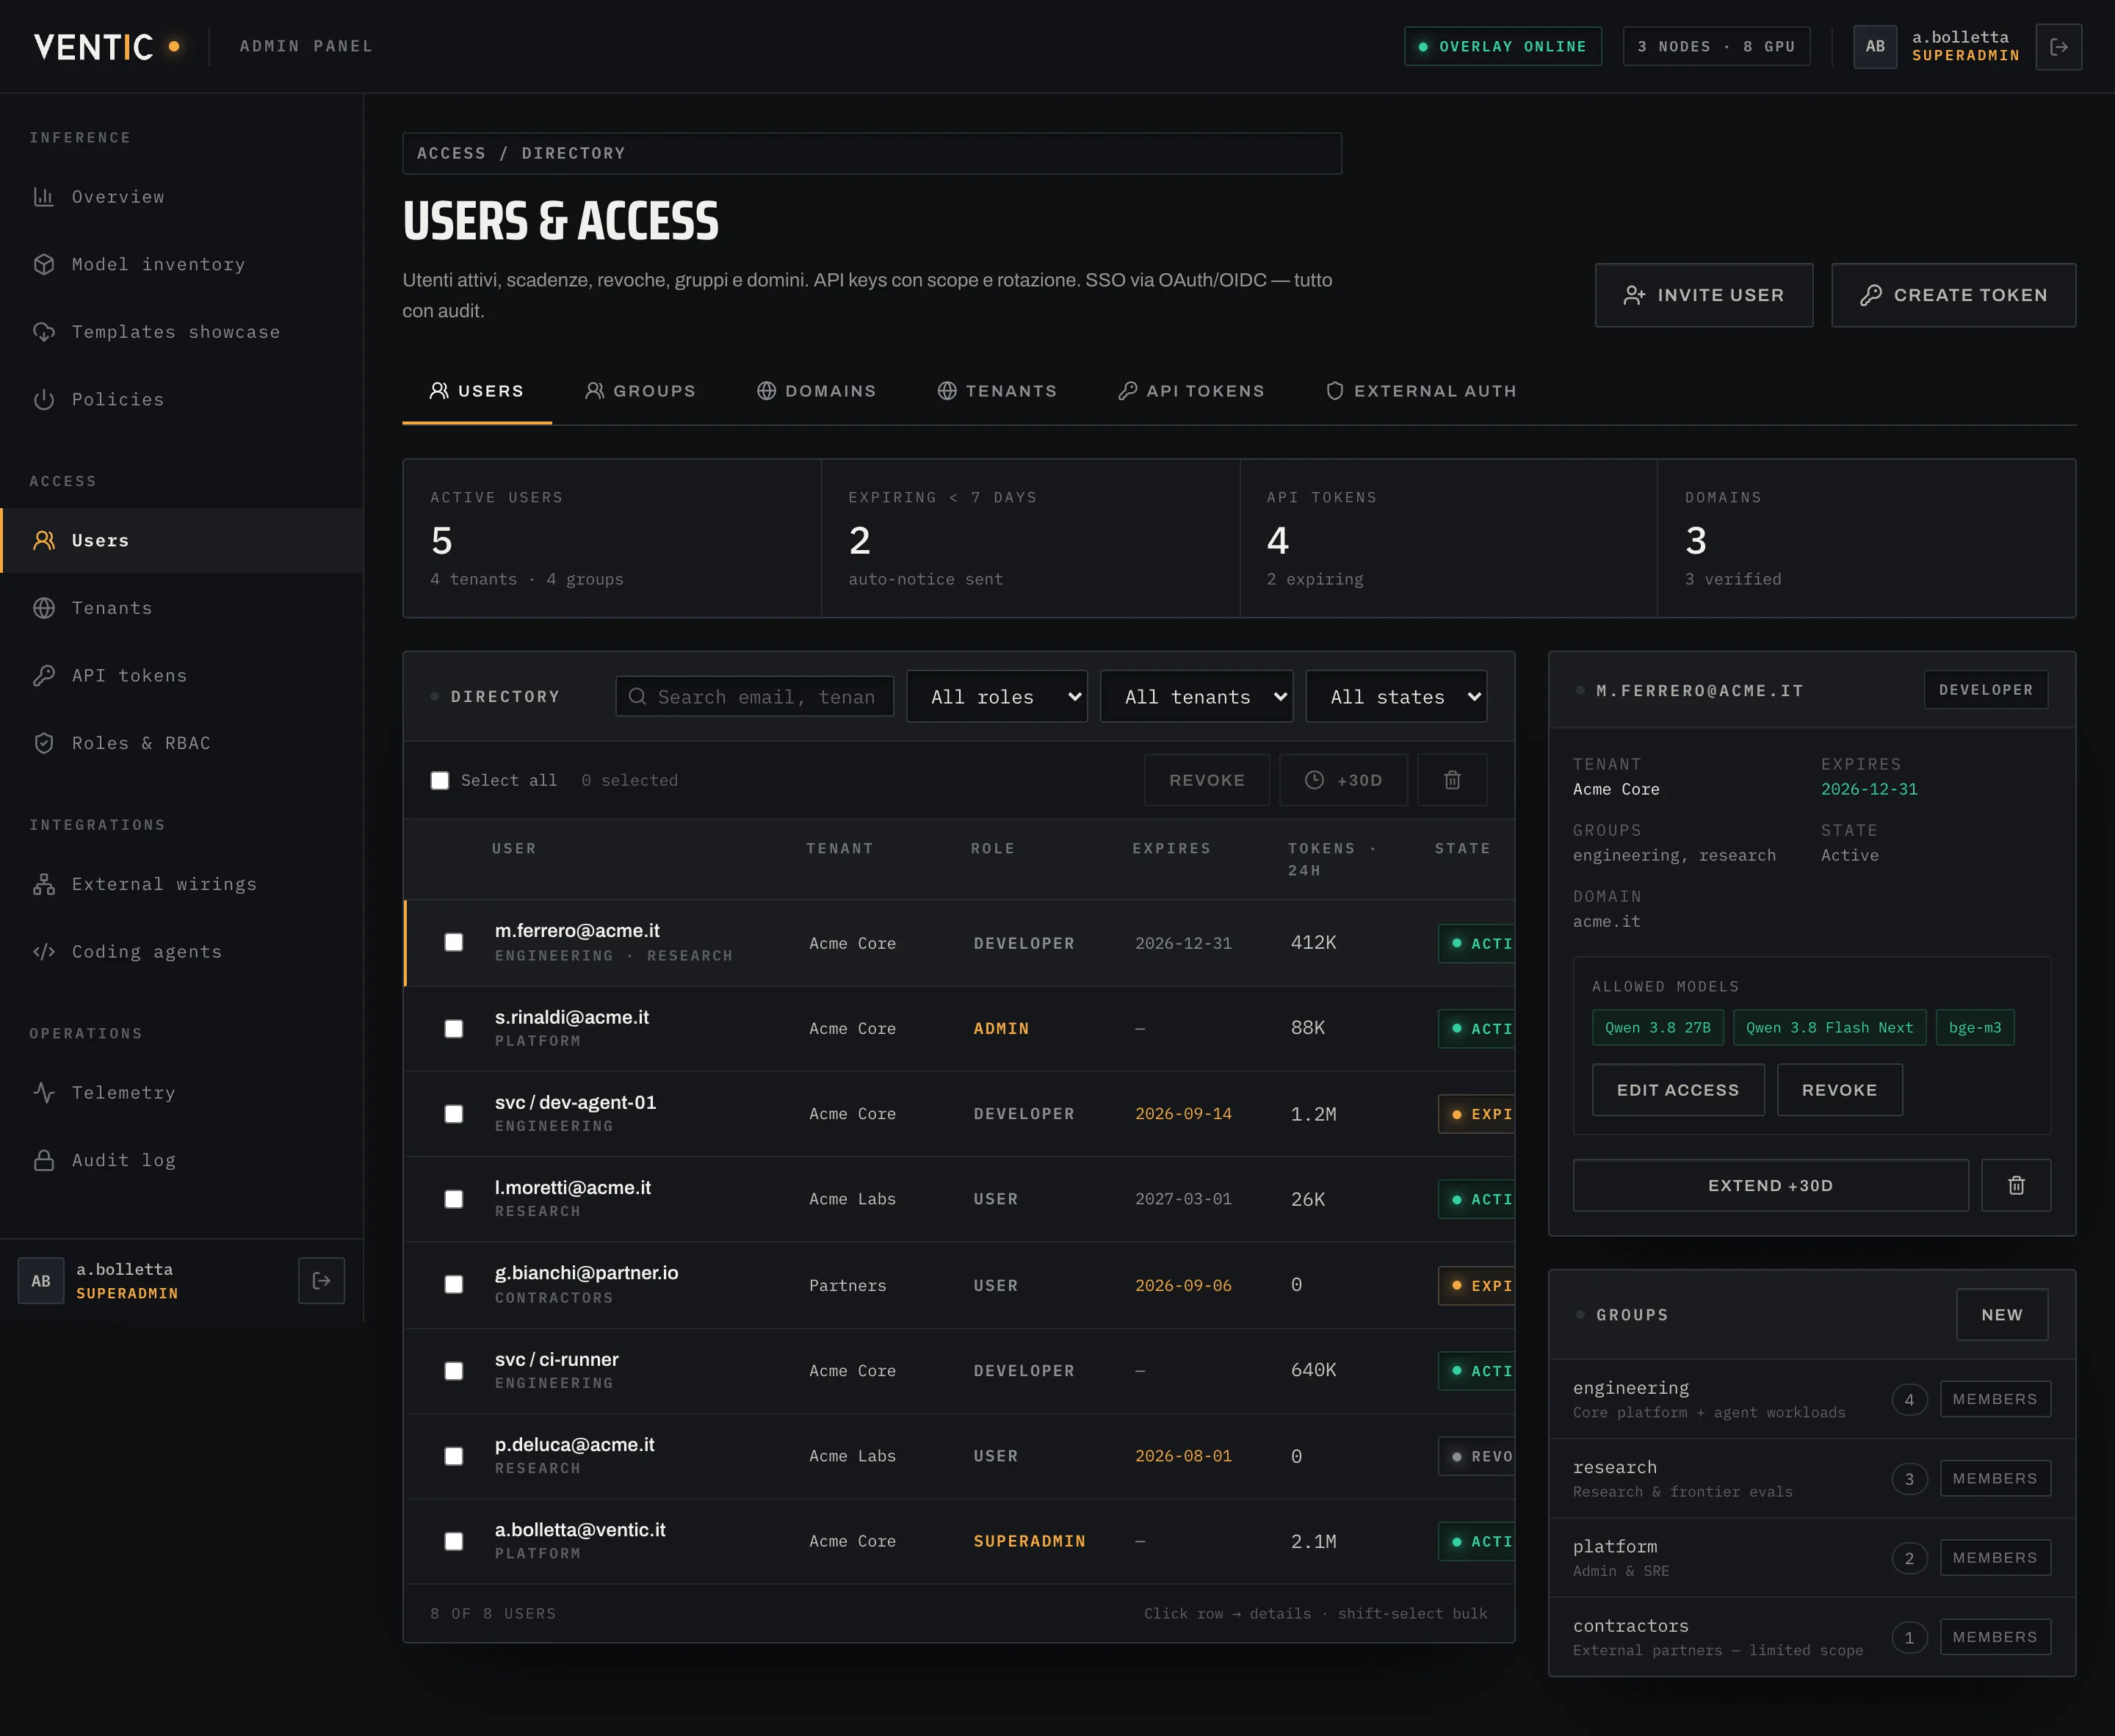
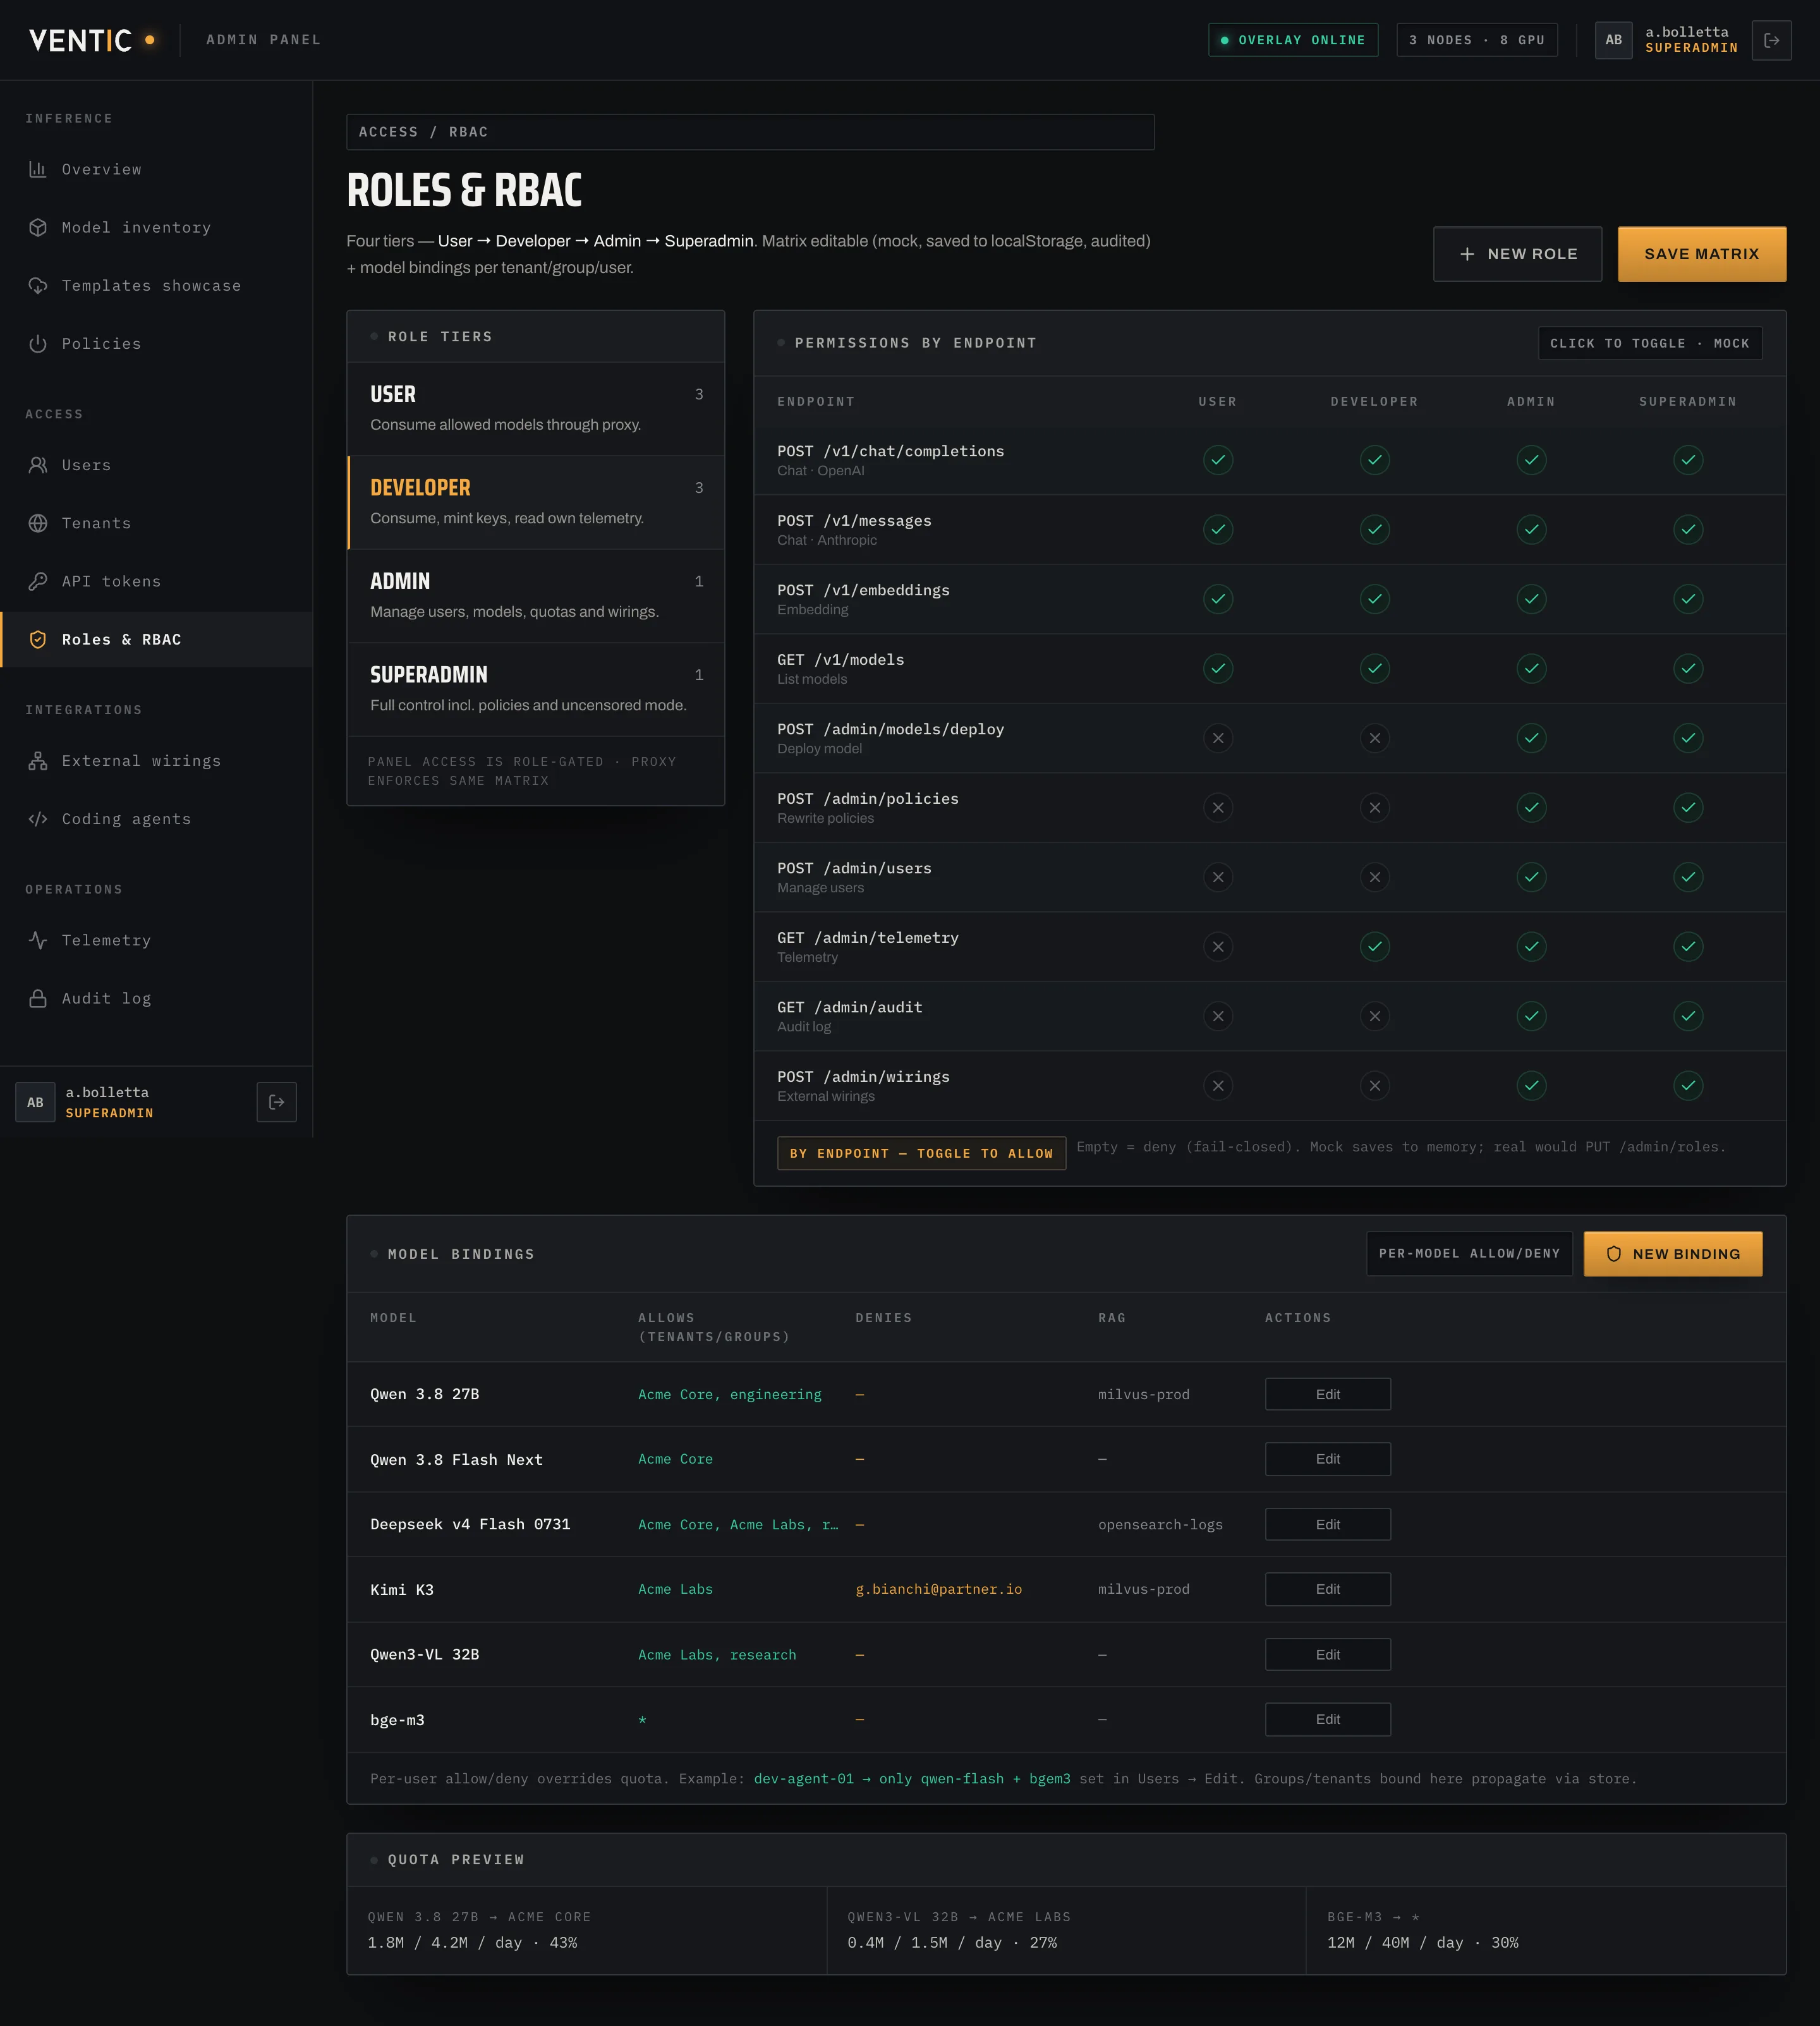
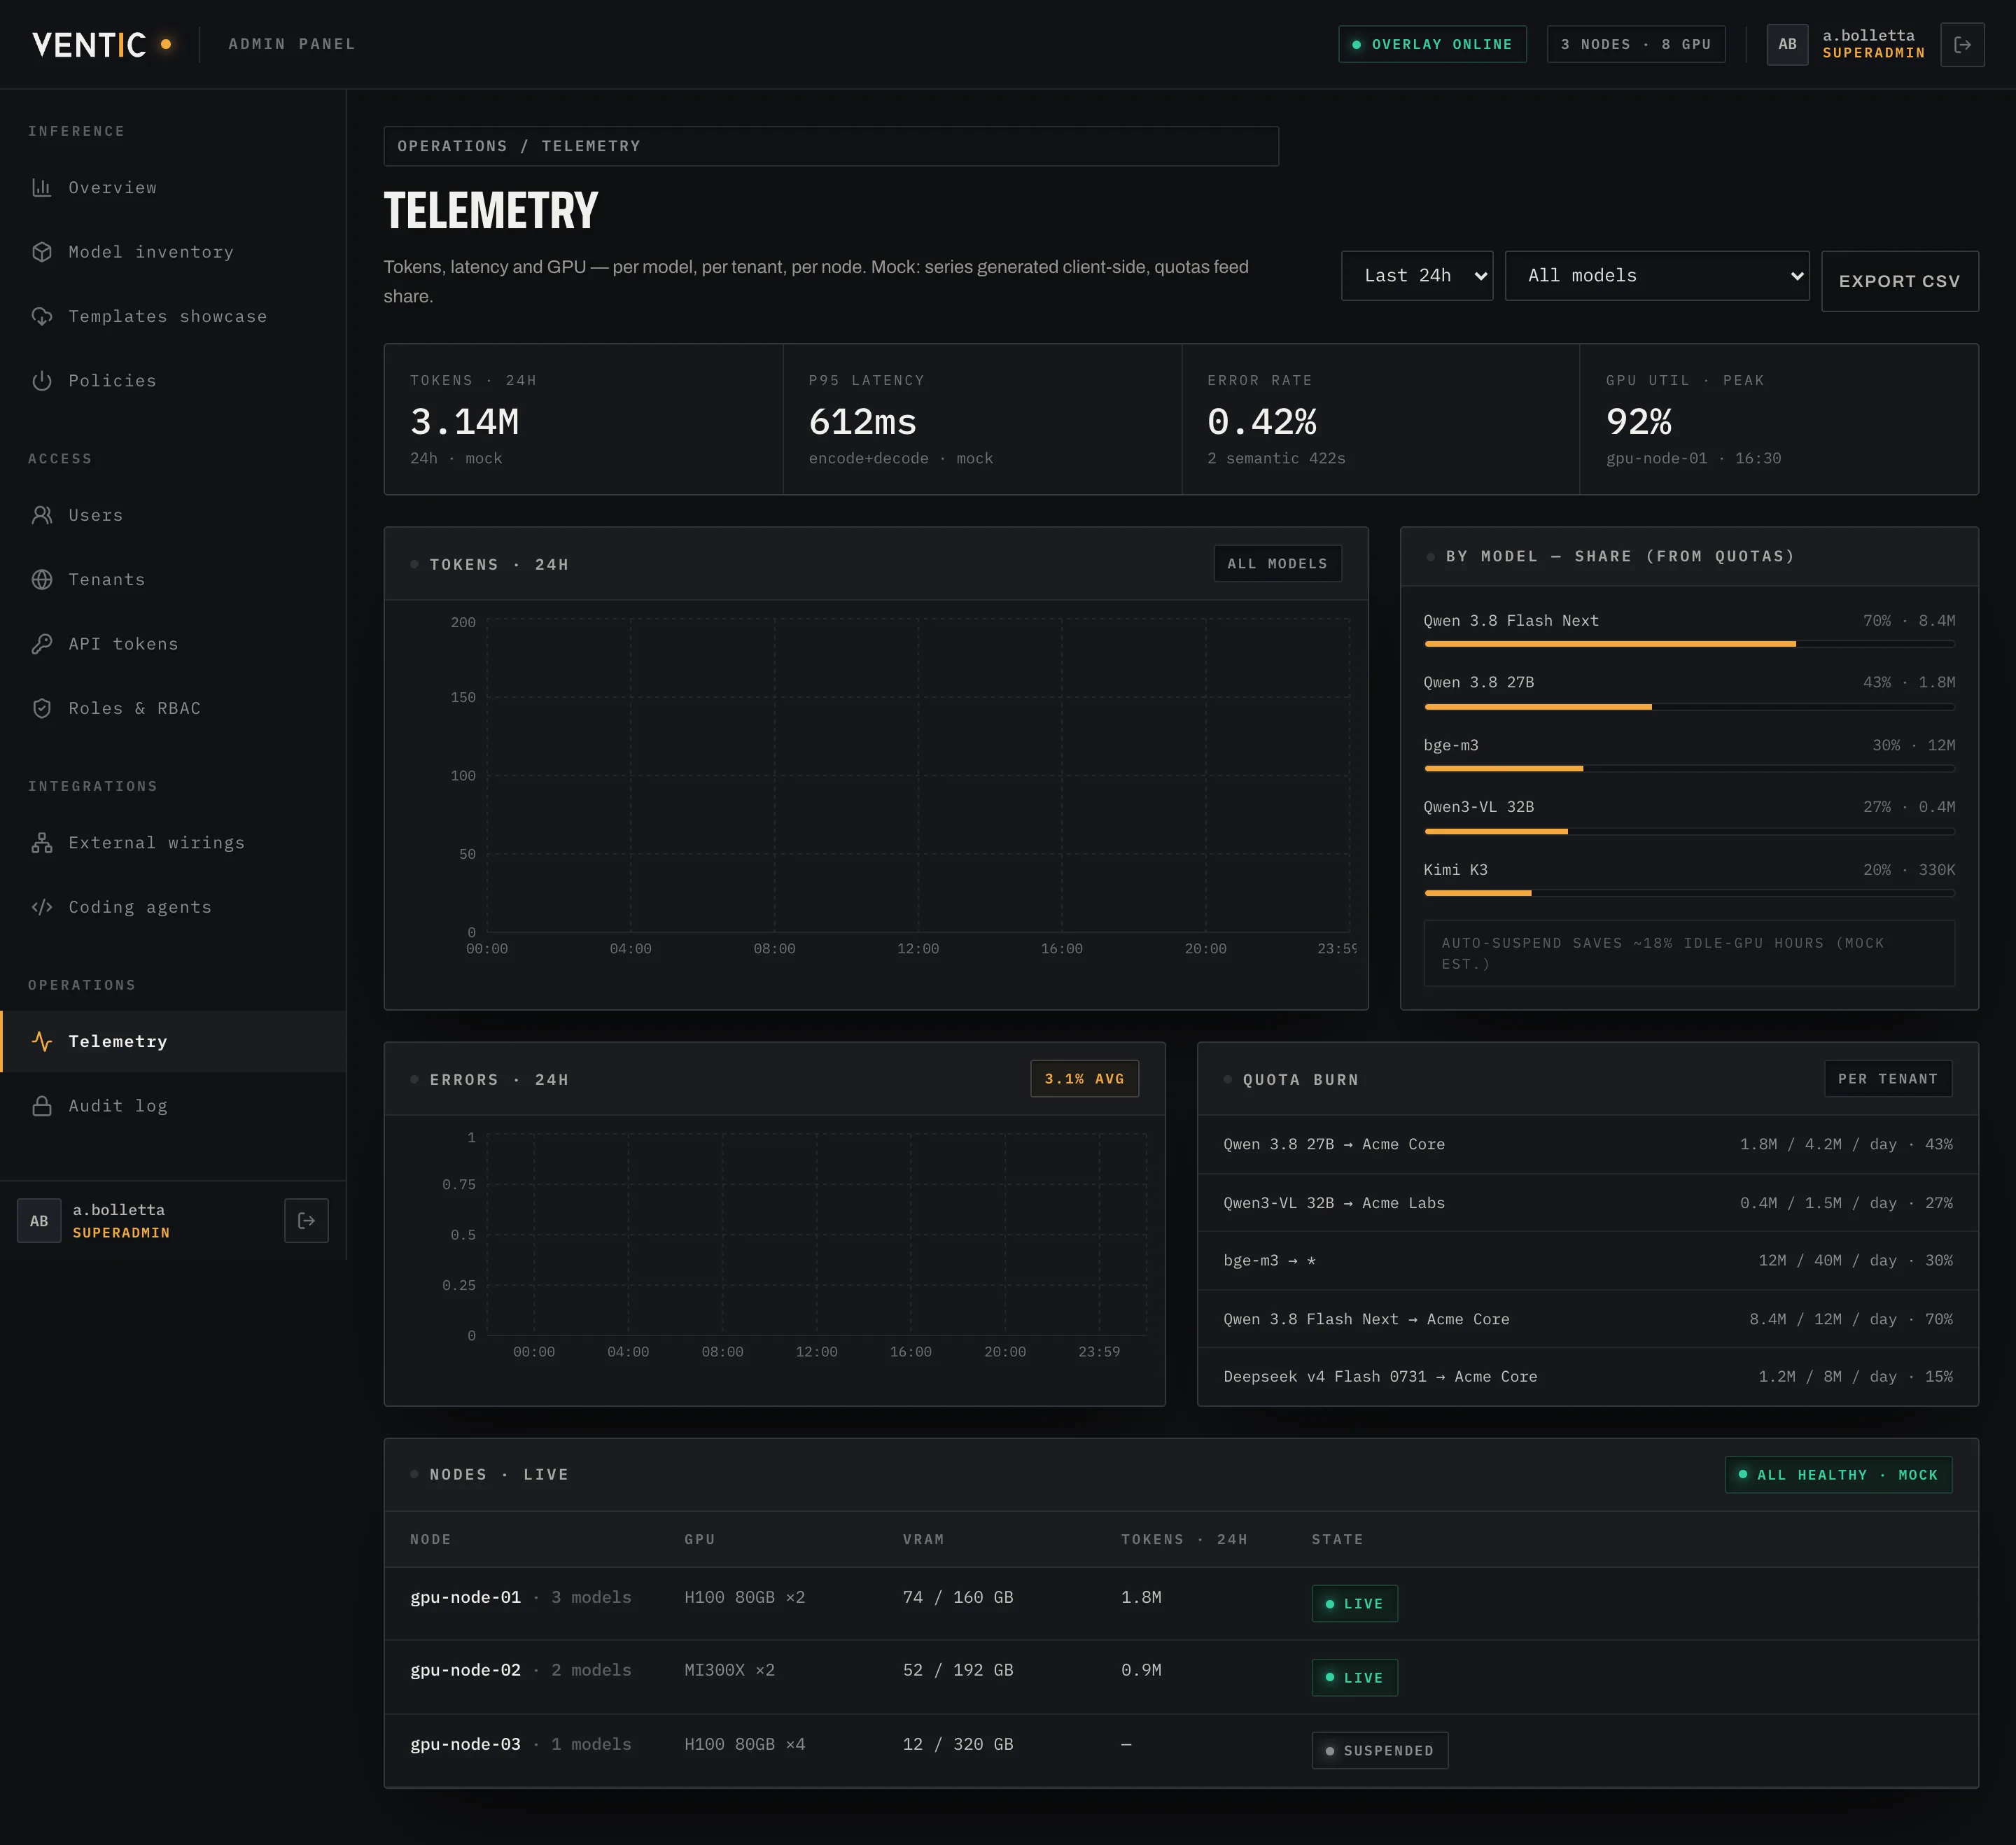
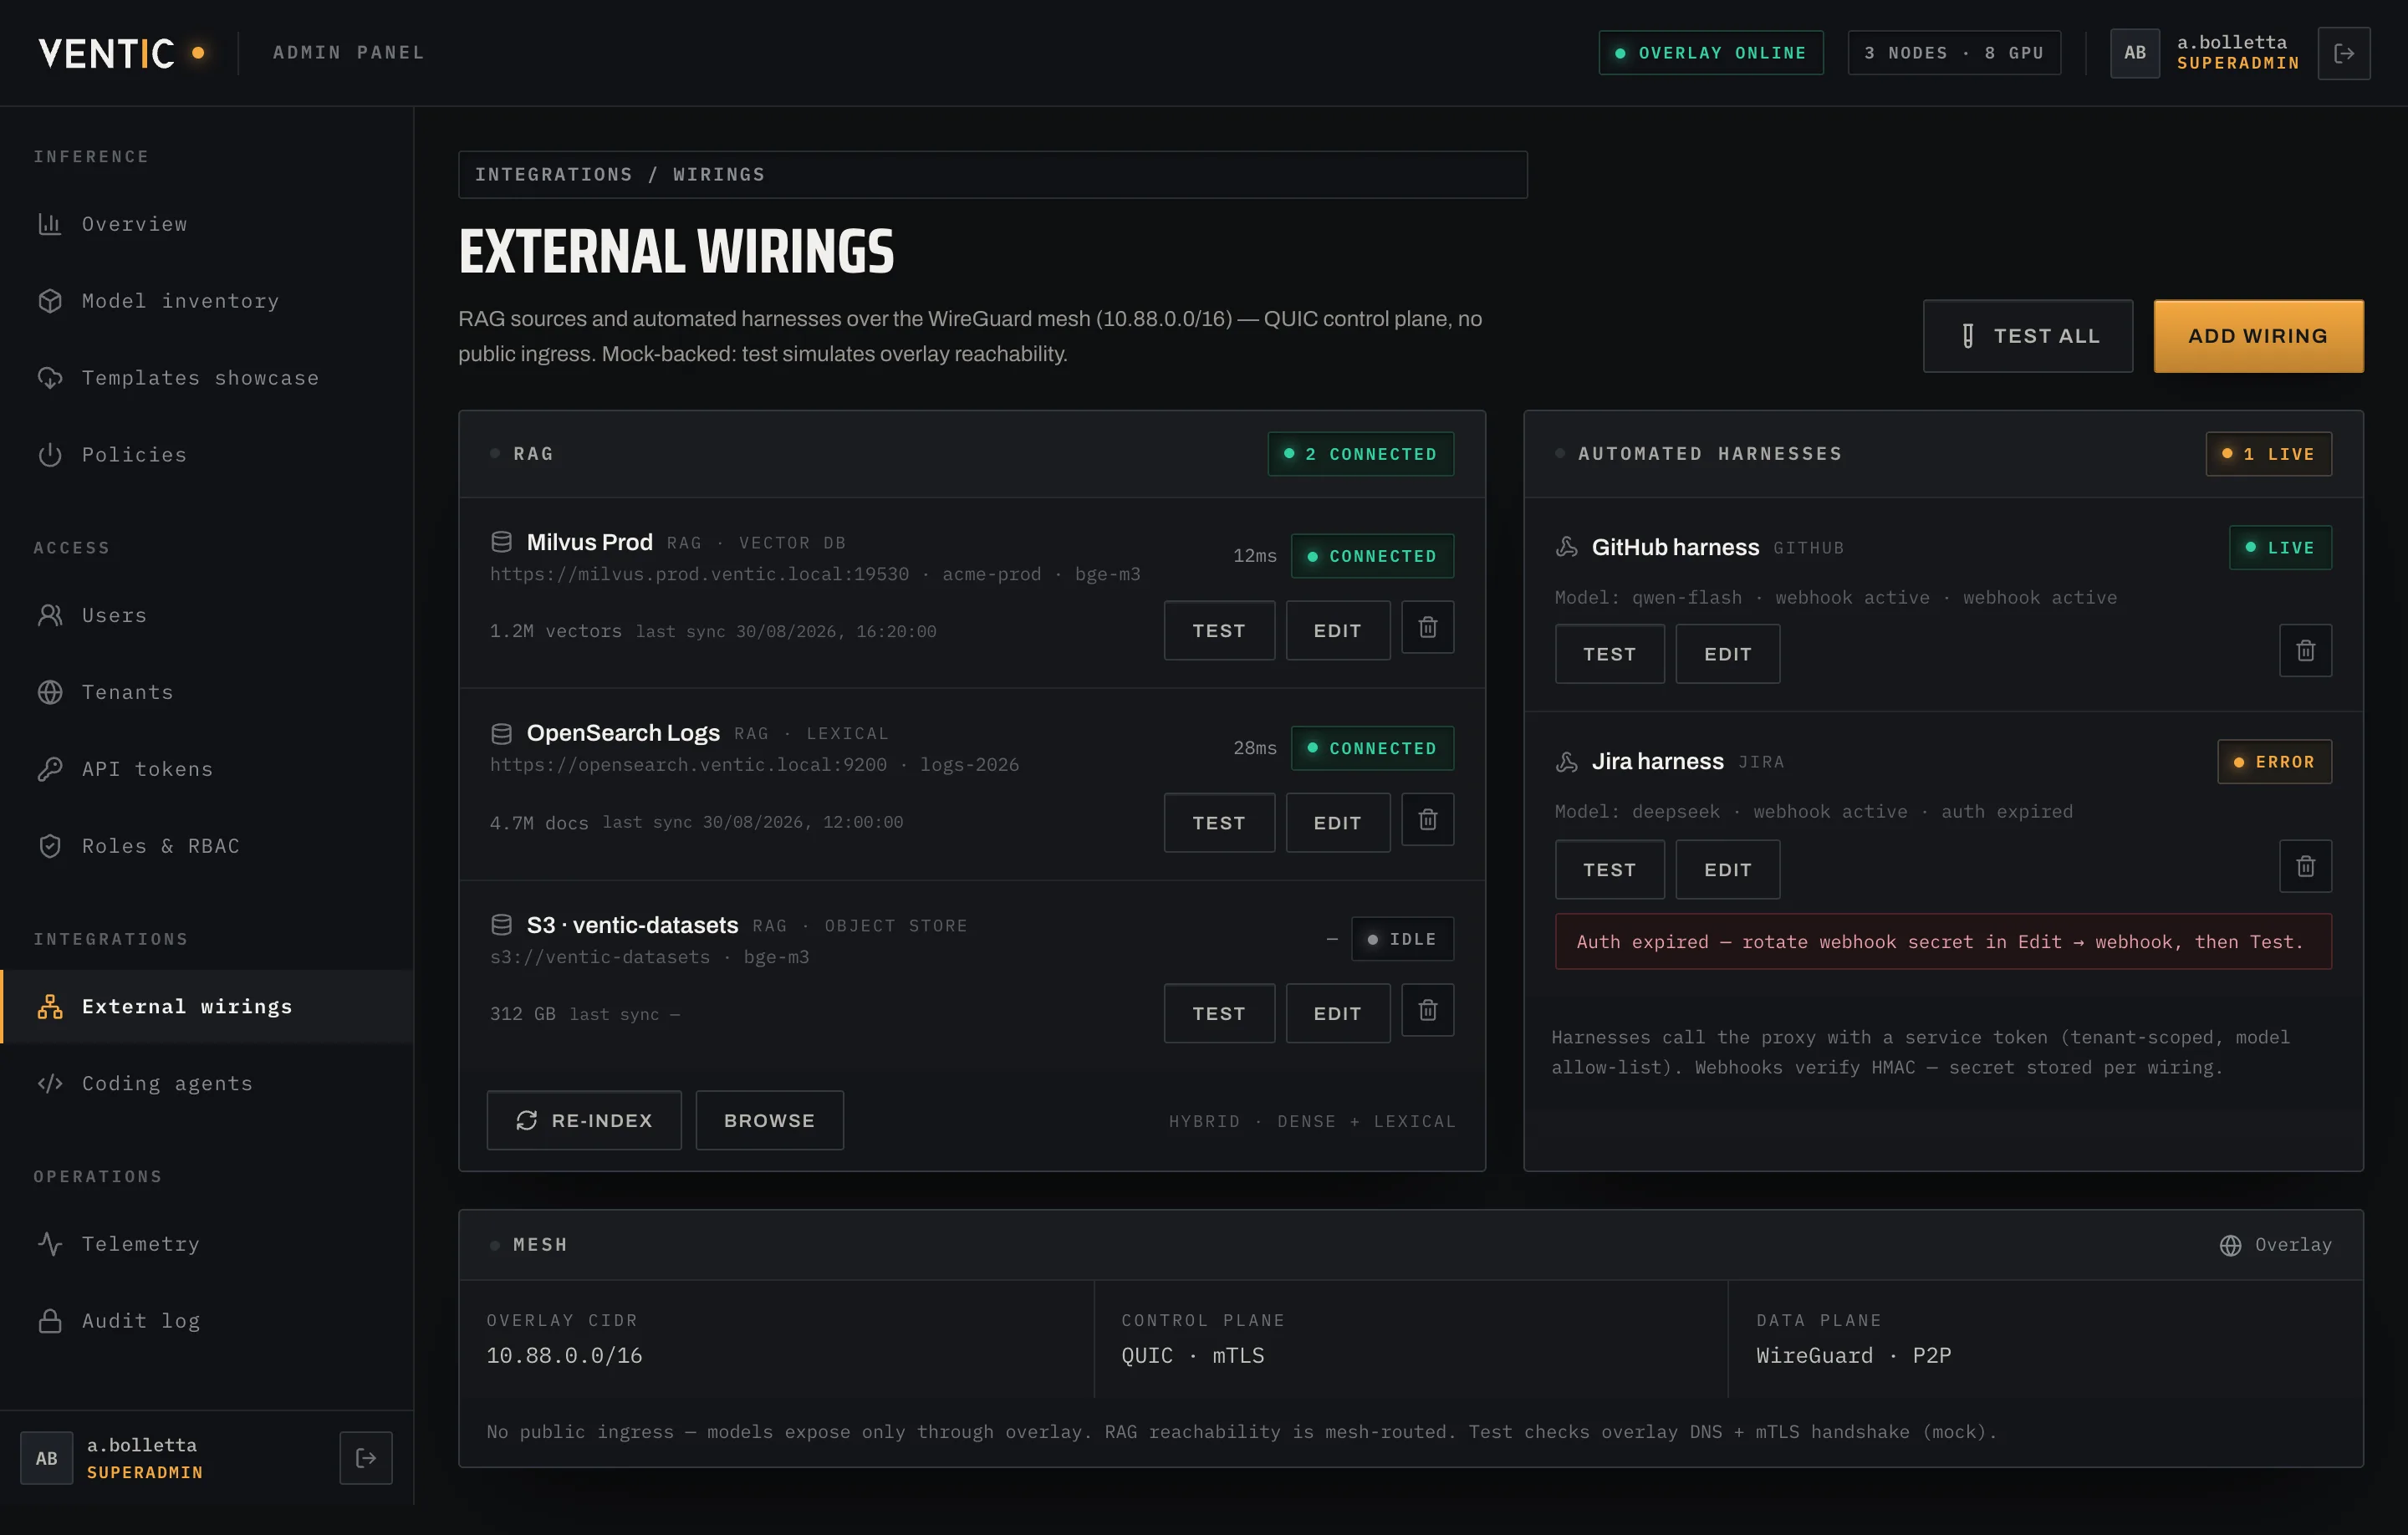
Utenti e accessi: utenti con tenant, ruolo, scadenza e consumo token, pannello provider di autenticazione e tabella API key.Ruoli e RBAC: matrice permessi per endpoint sui quattro ruoli e regole che legano soggetti ai modelli.Telemetria: grafico token al minuto, gauge GPU/VRAM per nodo, consumo per utente e allarmi recenti.Wiring esterni: connettori RAG, stato componenti, harness agentici e configurazione coding agent.
Pannello reale — dati di esempio
Ti suona familiare?

Ti capisco.

01

Limiti sui token e costi API fuori controllo?

Guidi un'azienda medio-grande e vuoi spostare i tuoi workload agentici e/o di vibe coding su un'infrastruttura di proprietà, con costi bassi e prevedibili? Lavori sotto pressione per il rischio di restare bloccato dai limiti giornalieri sui token, o di vedere i costi andare fuori controllo per il prezzo dei token via API?

02

Modelli open al posto di Sonnet 5, senza endpoint cinesi?

Vuoi tenere un piccolo abbonamento ai modelli frontier proprietari solo per le sfide più difficili, e spostare tutto il resto (il 95%) del carico LLM quotidiano su modelli come DeepSeek 4 (o 4.1) Flash al posto di Sonnet 5, ma hai problemi con gli endpoint API cinesi e le loro regole commerciali, e non ti fidi?

  • GPU a noleggio o hardware tuo

    Appoggiati a VM/container GPU a noleggio, accendendoli e spegnendoli solo quando serve, oppure usa il tuo hardware privato (o entrambi!).

  • Scaling

    Imposta le regole di scaling senza fatica.

  • Telemetria

    Tieni tutto sotto controllo con un potente sistema di telemetria.

  • Regole DLP

    Blocca qualsiasi fuga di dati o violazione di sicurezza con un potente sistema di regole DLP.

Video · 1:13

Ventic in poco
più di un minuto.

Perché i provider LLM non bastano, come funziona Ventic e cosa ottieni con un'infrastruttura LLM privata.

Perché Ventic

I provider di LLM
sono inadeguati.

Gli LLM dei Provider sono perfetti per attività estremamente specifiche e personali. Inadeguati per lavoro agentico e aziendale.

A subscription3 limiti
01 — SUBSCRIPTION

Finestre strette

Quota finita, lavoro fermo. Per una persona è attesa; per un agente notturno è un guasto che scopri al mattino.

02 — SUBSCRIPTION

Outage del provider

Se il provider va giù, va giù anche il tuo prodotto. Nessun failover ti salva se il modello vive solo da loro.

03 — SUBSCRIPTION

Modelli deprecati

Gli stessi prompt danno risultati diversi nel tempo. Aggiornamenti silenziosi, poca trasparenza, nessuna riproducibilità.

A token3 limiti
04 — A TOKEN

Prezzo per token

Sui modelli di frontiera USA il costo per token è alto e cresce proprio quando il tuo prodotto ha successo.

05 — A TOKEN

Compliance

Le alternative economiche girano su server fuori UE. Se i tuoi dati devono restare in UE, quella strada è chiusa.

06 — A TOKEN

Budget imprevedibile

Il consumo LLM è imprevedibile per natura. In azienda diventa una voce che nessuno riesce a chiudere a budget.

Due modi di iniziare

Usi il tuo server,
oppure lo troviamo noi.

In entrambi i casi ottieni la stessa cosa: un endpoint privato compatibile OpenAI e Anthropic, su una macchina a cui accedi quando vuoi.

BYOH — Bring Your Own Hardware

Utilizza i tuoi server

Hai già le GPU o le compri tu. Noi installiamo lo stack: verifica di compatibilità, motore di inferenza ottimizzato per la tua GPU (vLLM / SGLang), Ventic Agent, rete overlay cifrata, pannello e observability.

Licenza Ventic + setup€69,90/ mese + IVAper 5 postazioni incluse
5 incluse€69,90
+ €39,99
ogni 10 aggiuntive€39,99

Es. 15 posti → €109,89/mese · 25 posti → €149,88/mese

  • Verifica server e compatibilità — max 1 ora
  • Installazione completa dello stack di inferenza
  • Ventic Agent per accesso remoto cifrato

Licenza Ventic Stack solo su BYOH: €69,90/mese + IVA per 5 postazioni, €39,99 + IVA ogni 10 aggiuntive. Sconti per volumi. Setup iniziale su richiesta — puoi anche fare da solo.

PaaS

Utilizza i nostri server

Troviamo il server giusto al prezzo giusto nel nostro catalogo, lo mettiamo in produzione e te lo fatturiamo insieme al servizio. Tutto incluso — hardware e licenza compresi.

Tutto incluso, a oreda 1 €/ ora + IVAlicenza inclusa
hardware + licenzamai a token
  • Scelta su tuoi criteri: spot o dedicato, UE o US, datacenter o no
  • Acquisto con bonifico SEPA immediato
  • Spegnimento automatico quando nessuno lo usa
  • Multicloud per ridondanza o failover, se il servizio è critico

Paghi solo le ore in cui il server è acceso, licenza inclusa. Mai a token.

Come funziona

LLM per Aziende e Provider
in uno stack.

Una soluzione completa per rilasciare LLM a persone ed agenti in modo controllato. Come un Kubernetes enterprise per LLM: dichiari l'intento via GUI o manifest CLI, Ventic riconcilia lo stato desiderato — senza farti toccare driver, kernel o flag del motore di inferenza.

  1. 01

    Troviamo il server

    Cerchiamo la macchina giusta al prezzo giusto, secondo i criteri che scegli. Acquisto con bonifico SEPA immediato.

    solo PaaS
  2. 02

    Se non hai server, te lo diamo noi

    In pochi minuti configuriamo il tuo server. Oppure te lo forniamo noi, adeguato ai modelli che vuoi far girare con le caratteristiche che ti servono per il tuo workload — LLM ed embedding insieme su motore di inferenza ottimizzato (vLLM, SGLang).

    in pochi minuti
  3. 03

    Lo raggiungiamo senza aprire porte

    Rete overlay privata e cifrata che si autoconfigura e attraversa i NAT. Niente IP pubblico, niente VPN da mantenere, nessuna porta esposta.

    zero esposizione
  4. 04

    Gestiamo la lifecycle

    Scheduling equo fra utenti, ripristino automatico dopo outage spot, spegnimento nei momenti morti, metriche e allarmi. Con la nostra assistenza.

    continuo

Lifecycle di una richiesta

La tua app parla al proxy come se fosse OpenAI. Il proxy inoltra sull’overlay cifrato fino al Ventic Agent sul nodo GPU. La risposta torna dalla stessa strada — nessun hop pubblico.

01
La tua app

SDK OpenAI / Anthropic invariato. Cambia solo l’URL dell’endpoint.

02
LLM proxy

Un unico endpoint. Autentica, applica RBAC e quote, poi inoltra.

03
Overlay cifrato

Canale mTLS che attraversa i NAT. I nodi non espongono porte.

04
Ventic Agent

Riceve, accoda in modo equo, alimenta il motore di inferenza.

05
Motore di inferenza

Inferenza ottimizzata per quel modello su quella GPU (vLLM / SGLang). Risponde al proxy, il proxy a te.

Senza IP pubblico. Senza VPN manuale. Il relay può stare in rete pubblica; i tuoi nodi restano chiusi.
PERCORSO DELLA RICHIESTAIl control plane e il provisioner restano fuori dal percorso dati01APPSDK invariato02LLM PROXYauth · RBAC · quote03OVERLAY mTLSattraversa i NAT04VENTIC AGENTcoda equa05MOTOREvLLM · SGLangrisposta — stessa strada al contrario

Dichiari l'intento. Ventic riconcilia.

Come su Kubernetes: descrivi l'endpoint in un manifest, lo applichi da CLI e ricevi accessi pronti all'uso — che poi usi davvero, ad esempio dentro opencode.

llm-team.yaml
yaml
apiVersion: ventic.io/v1kind: LLMEndpointmetadata:  name: team-coding  tenant: acmespec:  model: qwen3.8-27b  engine: vllm  # TP=2, ottimizzato per la GPU  replicas: 2  region: eu-south  network:    overlay: mTLS    publicIP: none  auth:    rbac: [dev, agent]    quota: 2M tokens/day  scale:    toZero: 15m  # spegne quando nessuno lo usa    maxReplicas: 4
manifest · intent-based, come Kubernetes
terminale
dev@acme:~/acme$ventic apply -f llm-team.yaml

manifest valido — kind: LLMEndpoint / team-coding (tenant: acme)

→ intento inviato al control plane…

✓ nodo gpu-node-03 agganciato via overlay mTLS · eu-south · nessun IP pubblico

✓ pesi qwen3.8-27b caricati · motore vLLM (TP=2) avviato

✓ endpoint READY in 3m 12s · repliche 2/2 · scale-to-zero 15m

accessi emessi — tenant acme

export OPENAI_BASE_URL="https://llm.ventic.local/v1"export OPENAI_API_KEY="sk-vent-7f3a…9c2e"export ANTHROPIC_BASE_URL="https://llm.ventic.local/anthropic"export ANTHROPIC_AUTH_TOKEN="sk-vent-7f3a…9c2e"
dev@acme:~/acme$opencode run "aggiungi retry con backoff a syncBilling() e copri con test"

◆ opencode · modello ventic/qwen3.8-27b via proxy privato

◇ letto src/billing.ts (212 righe) + 2 file correlati — contesto resta in overlay

◇ patch src/billing.ts + tests/billing.test.ts

✓ test: 14 passed · diff pronto da committare

✓ fatto via LLM privato — 0 token fatturati al provider pubblico

dev@acme:~/acme$
Demo registrata — chiavi ed endpoint di esempio
Piattaforma

Uno stack che possiedi,
non un servizio a cui invii i dati.

Pannello, proxy e observability girano sulla tua infrastruttura Docker — i dati restano da te. Sui nodi GPU gira solo il nostro agent. In mezzo, una rete overlay cifrata che si autoconfigura e attraversa i NAT senza IP pubblici né VPN da mantenere. Un Kubernetes enterprise per LLM: intent-based, gestisci tutto da GUI o via CLI con manifest file — dichiari lo stato desiderato, Ventic lo riconcilia.

Sempre inclusoOpzionale — attivi solo se ti serve
Come interagiscono i componenti e dove sonoNodi chiusi · nessun IP pubblico · mTLS
POSTAZIONI DI LAVOROSDK invariato — cambia solo l'URLLA TUA INFRASTRUTTURA DOCKERon-prem o cloud — i dati restano quiOVERLAYcifrato mTLSNODI DI INFERENZAGPU tue o dal catalogoCONTROL PLANE VENTICremoto — gestito da noi, sempre presenteAPI OpenAI / Anthropicoverlay mTLSaccende / spegne — solo le tue macchineintento · manifestaggancia il nodo al tuo overlayacquisisceAGENTI DI CODINGClaude Code · Copilot · CursorAPP E SERVIZIbackend · job · automazioniOPENAI / ANTHROPICSDK e tool esistentiLLM PROXYendpoint unico · auth · RBAC · quoteADMIN PANELutenti · modelli · policyOBSERVABILITY LGTMlog · metriche · tracceINP ON-PREMvede e gestisce solo le tue macchineopzionaleOPENRAG · QDRANT · HARNESSmoduli attivabili a richiestaRELAYmTLS · NATINP PAASriceve l'intento e procura i nodiscala oltre le tue macchine, anche da on-premsempre attivoBILLING & RESALEuso per tenant · rivenditasubscription o a tokenin arrivoCATALOGO GPU CLOUDspot o dedicato · UE / USacquisto SEPA immediatogpu-node-012×H100 80GBgpu-node-022×MI300Xgpu-node-03autosi accende al bisognoSlot accesi = repliche del modello attive su quel nodo.nessun IP pubbliconessuna VPN da gestire
Percorso dati — richiesta e rispostaOverlay cifrato mTLSPercorso di controllo — provisioningOpzionale o in arrivo
Autoscaling & scale-to-zero
  • Oltre 80% di carico: aggiunge una replica.
  • Sotto 25% per 10 minuti: ne toglie una.
  • 0 richieste per 15 minuti: spegne il nodo. Si riaccende alla prima chiamata.
Inference Node Provisioner (INP)
INP on-premise (opzionale)solo tue macchine

Gira nella tua infra. Vede e gestisce solo le macchine del cliente: le accende/spegne secondo i manifest. Se non c'è, lo scaling è delegato al Provisioner Ventic.

INP PaaS — lato Ventic (sempre presente)sempre attivo

Gira sul control plane Ventic. Acquisisce GPU in cloud (spot/dedicato, UE/US) e le aggancia via overlay al tuo stack — anche quando parti da on-prem e devi scalare oltre le tue macchine.

Billing & Resalein arrivo

Contabilizza uso per tenant e prepara rivendita a subscription o a token. Architettura già predisposta — funzionalità in arrivo.

INP PaaS lato Ventic esiste sempre e può rifornire anche lo stack on-prem — INP on-prem è opzionale e vede solo le tue macchine. Billing in arrivo per resale subscription/token.

Ciclo di vita

Si adatta al carico. Si spegne quando non serve.

> 80% carico

Aggiunge una replica GPU per assorbire il picco.

< 25% per 10 min

Rimuove una replica. Paghi solo ciò che usi.

0 richieste per 15 min

Spegne il nodo. Si riaccende da solo alla prima chiamata.

Spot revocato

L’agent rischedula su un altro provider senza intervento manuale.

INFERENCE NODE PROVISIONERosserva il carico, decide e attua — on-prem o lato Ventic> 80% di carico< 25% per 10 min0 richieste per 15 min1ª chiamata → riaccensionerischedula su un altro providerIN ESERCIZIOn repliche attiveSCALE OUT+1 replica GPUSCALE IN−1 replicaSPENTOscale-to-zero · costo 0SPOT REVOCATOre-provisioning automatico

Tutto automatico. Nessun intervento notturno.

01

Le tue postazioni

Sui desktop del team
Coding Agent wiring tool

Configura da solo l’agente di coding che già usate. Nessun endpoint da incollare a mano.

02

La tua infrastruttura Docker

Dove decidi tu — on-prem o cloud
Admin panel

Utenti, ruoli, modelli, quote e policy. È il pannello che vedi qui sotto.

LLM proxy

Un endpoint solo, compatibile OpenAI e Anthropic. I client esistenti non cambiano.

Observability (LGTM + Grafana)

Log, metriche e tracce. I dati di utilizzo restano sulla tua infra.

Inference Node Provisioner (on-prem)Opzionale — attivi solo se ti serve

Opzionale. Gira nella tua infra e vede solo le tue macchine: le accende/spegne secondo i manifest. Se non c'è, lo scaling è delegato al Provisioner Ventic.

OpenRAGOpzionale — attivi solo se ti serve

Pipeline di retrieval sui tuoi documenti.

QdrantOpzionale — attivi solo se ti serve

Database vettoriale per le collection RAG.

Embedding modelOpzionale — attivi solo se ti serve

Indicizzazione servita dallo stesso stack di inferenza.

Deepseek harnessOpzionale — attivi solo se ti serve

Harness agentico pronto da collegare a un modello.

OpenclawOpzionale — attivi solo se ti serve

Harness agentico alternativo, stessa procedura.

Adapter LangChainOpzionale — attivi solo se ti serve

Integrazione nativa con LangChain: i tuoi chain e tool chiamano Ventic come fosse OpenAI, con tracing OpenTelemetry completo.

Nodo n8nOpzionale — attivi solo se ti serve

Workflow n8n con nodo Ventic: automazioni no-code che restano dentro la tua rete, senza inviare dati a provider esterni.

Observability agenticaOpzionale — attivi solo se ti serve

Tracciamento di ogni chiamata agente in Grafana/LGTM: latenza, token, errori e allarmi sul canale che preferisci.

03

Rete overlay cifrata

Relay in rete pubblica, nodi chiusi
Relay node

Instrada il traffico verso host che non espongono nulla su internet. I tuoi nodi restano chiusi anche dietro NAT.

04

I nodi di inferenza

Sulle GPU — tue o dal catalogo
Ventic host agent

Tiene in piedi il modello, lo espone sull’overlay e lo condivide equamente. È l’unico pezzo sul nodo.

Motore di inferenza

Basato su vLLM e SGLang, ottimizzato per quel modello su quella GPU. Serve LLM ed embedding insieme.

05

Control Plane Ventic (remoto)

Gestito da noi — sempre presente
Inference Node Provisioner (PaaS)

Sempre attivo lato Ventic. Riceve l'intento dal tuo stack, acquisisce GPU in cloud (spot/dedicato, UE/US) e le aggancia via overlay — anche quando parti da on-prem e devi scalare oltre le tue macchine.

Billing & Resale — in arrivoOpzionale — attivi solo se ti serve

Contabilizza uso per tenant e prepara rivendita a subscription o a token. Architettura già predisposta — funzionalità in arrivo.

Parti dal minimo (agent + overlay + proxy) e aggiungi solo ciò che ti serve. INP PaaS lato Ventic è sempre presente e può rifornire anche lo stack on-prem; INP on-prem è opzionale e vede solo le tue macchine.

Cosa ottieni

Tutto ciò che serve
per non doverci pensare.

Prenota una call tecnica

Sempre in piedi

Se l’istanza spot viene revocata, Ventic rischedula e ripristina da solo — anche su un altro provider.

Multi-utente equo

Una macchina condivisa fra più persone: finestre di contesto prevedibili, workload schedulato in modo esatto.

Nessun IP pubblico

L’overlay cifrato attraversa i NAT e raggiunge il server anche se non è esposto. Si autoconfigura: niente porte aperte.

Observability

GPU, CPU e OS sotto controllo, consumo token per utente in tempo reale, allarmi sul canale che preferisci.

Account e API key

Crei, ruoti e revochi utenti e chiavi dal pannello. 2FA e integrazione con provider esterni.

Scale to zero

Se nessuno usa l’LLM, l’istanza si spegne e riparte alla prima richiesta. Zero ore bruciate.

Policy sui contenuti

Vedi come sono usate le sessioni e applichi filtri per utente o per chiave.

Modelli uncensored

Quando i filtri commerciali bloccano il lavoro: hardening, red teaming, bug bounty.

Multicloud

Stesso modello su più provider, in ridondanza o failover: se uno si ferma, il servizio no.

Agenti autonomi 24/7

LangChain, n8n e harness OpenClaw/DeepSeek: i tuoi agenti girano tutta la notte sull'endpoint privato, senza finestre né rate limit del provider.

Workflow n8n & automazioni

Un nodo n8n che chiama Ventic come fosse OpenAI: pipeline no-code interne, senza webhook verso l’esterno né dati che lasciano la rete.

Observability agentica

Tracce OpenTelemetry su ogni chiamata agente — latenza, token ed errori in Grafana/LGTM, con allarmi sul canale che preferisci.

Modelli

Il meglio dell’open-weight,
per coding e agenti.

Tre fasce di costo e intelligenza. Scegliamo il modello insieme, in base al lavoro e alla GPU che hai davanti.

ModelloFasciaIdeale per
Qwen 3.8 27BEfficienteVolumi alti e coding assistito, al costo per risposta più basso.
Qwen 3.8 Flash NextVeloceAgenti con molti passi: dove la latenza pesa più della profondità.
Deepseek v4 Flash 0731BilanciataIl compromesso di riferimento fra qualità sul codice e throughput.
Kimi K3FrontierLavoro agentico più difficile, quando serve il massimo dell’open-weight.

VRAM, finestra di contesto e configurazione del motore di inferenza li fissiamo insieme durante l’analisi del server.

Pesi open-weight,
server tuo.

I migliori open-weight sono disponibili pubblicamente. Usarli via API esterna significa mandare i dati sui server di terzi — per molte aziende è inaccettabile.

Con Ventic scarichi i pesi e li fai girare sulla tua macchina, dove hai deciso tu. Il modello è aperto; i tuoi dati restano da te.

UEUSon-prem
Pesi bloccati, risultati stabili

Il modello installato oggi è identico fra sei mesi, byte per byte. Nessun aggiornamento silenzioso: le valutazioni restano valide, i prompt si comportano allo stesso modo.

Prezzi

Tre numeri.
Nessuna sorpresa.

Non fatturiamo a token. In BYOH (Bring Your Own Hardware) paghi la licenza a postazioni. In PaaS paghi a ore, licenza inclusa. Quanto scrive il modello non cambia il conto.

Confronto e costi per utente
BYOH · Licenza Ventic Stacksolo BYOH
€69,90/ mese + IVA
5 incluse€69,90
+ €39,99 / 10

Es. 15 → €109,89 · 25 → €149,88

Solo su BYOH: 5 postazioni incluse. Ogni blocco di 10 aggiuntive: €39,99 + IVA. Sconti per volumi. Setup su richiesta, fai-da-te possibile.

PaaS · Ventic 16licenza inclusa
1 €/ h + IVA
hardware+ licenzaa ore

Qwen 3.8 27B. 16 utenti attivi, fino a 100 in organico. 160 €/mese su orario d’ufficio, licenza inclusa.

PaaS · Ventic 64licenza inclusa
6 €/ h + IVA
hardware+ licenzaa ore

Deepseek v4 Flash 0731. 64 utenti attivi, fino a 500 in organico. 960 €/mese su orario d’ufficio, licenza inclusa.

Prezzi di lancio, IVA esclusa · licenza solo su BYOH: €69,90/mese per 5 postazioni + €39,99 ogni 10 aggiuntive · orario d’ufficio = 8 h × 20 gg = 160 h/mese · PaaS: hardware e licenza inclusi nella tariffa oraria · I prezzi indicati sono riservati alla early access alpha

Inizia ora

Contattaci
per cominciare subito.

Ti aiutiamo a scegliere il setup giusto — BYOH con i tuoi server o PaaS con i nostri — e partiamo direttamente dal workload che vuoi portare in produzione. Accesso in Alpha stage su invito.